公開日:2026年11月11日
■はじめに
AIデータプラットフォームアーキテクトとして活動しているネットインテグレーション事業部の左手です。「AIエージェントを試したいが、社内データをどこまで触らせてよいか判断できない」
「エージェントが実行した操作を、後から『誰の指示で動いたのか』と説明できるだろうか」
このような声を聞く機会が増えてきました。
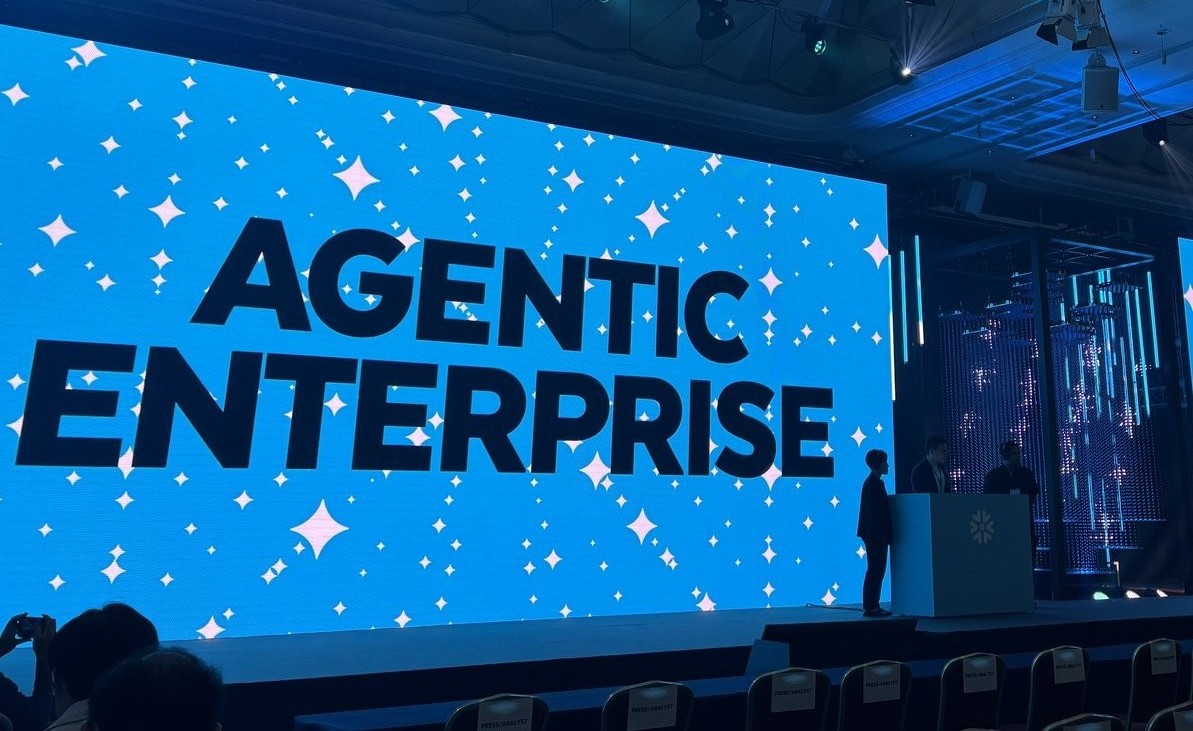
2026年9月の「Snowflake World Tour Tokyo 2026」(以下、SWTT 2026)では、構想より先に実際に動くデモが披露され、全社約650の業務のうち120件でAIエージェント向けのスキル化に着手した国内事例なども紹介されました。
こうした発表から、Agentic Enterprise(定型業務はエージェントが担い、人は方向づけと意思決定に時間を使う組織)が「実践」の段階に入ったことを実感しました。
本記事では、AIエージェントのガバナンスとは何か、なぜ従来の統制では不十分なのか、そしてその中心となる「エージェントID」の考え方を、データ基盤の視点から解説します。
■執筆者
左手 克明
Katsuaki Sate
ソリューションビジネスユニット ネットソリューション事業本部
■目次
AIエージェントのガバナンスとは なぜ「人向けの統制」だけでは足りないのか ガバナンスを支える3つの柱:識別・権限・監査 エージェントIDの2つの形:委任型と自律型 データ基盤側で実装するポイント(Snowflakeの例) 導入時の注意点 まとめ 富士ソフトのデータ利活用支援について
■本文
1.AIエージェントのガバナンスとは
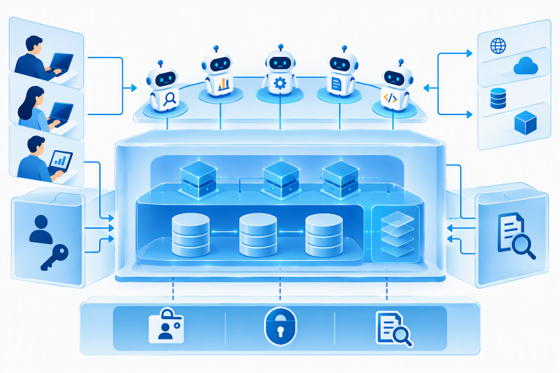
◆AIエージェントのガバナンスの全体像
2.なぜ「人向けの統制」だけでは足りないのか
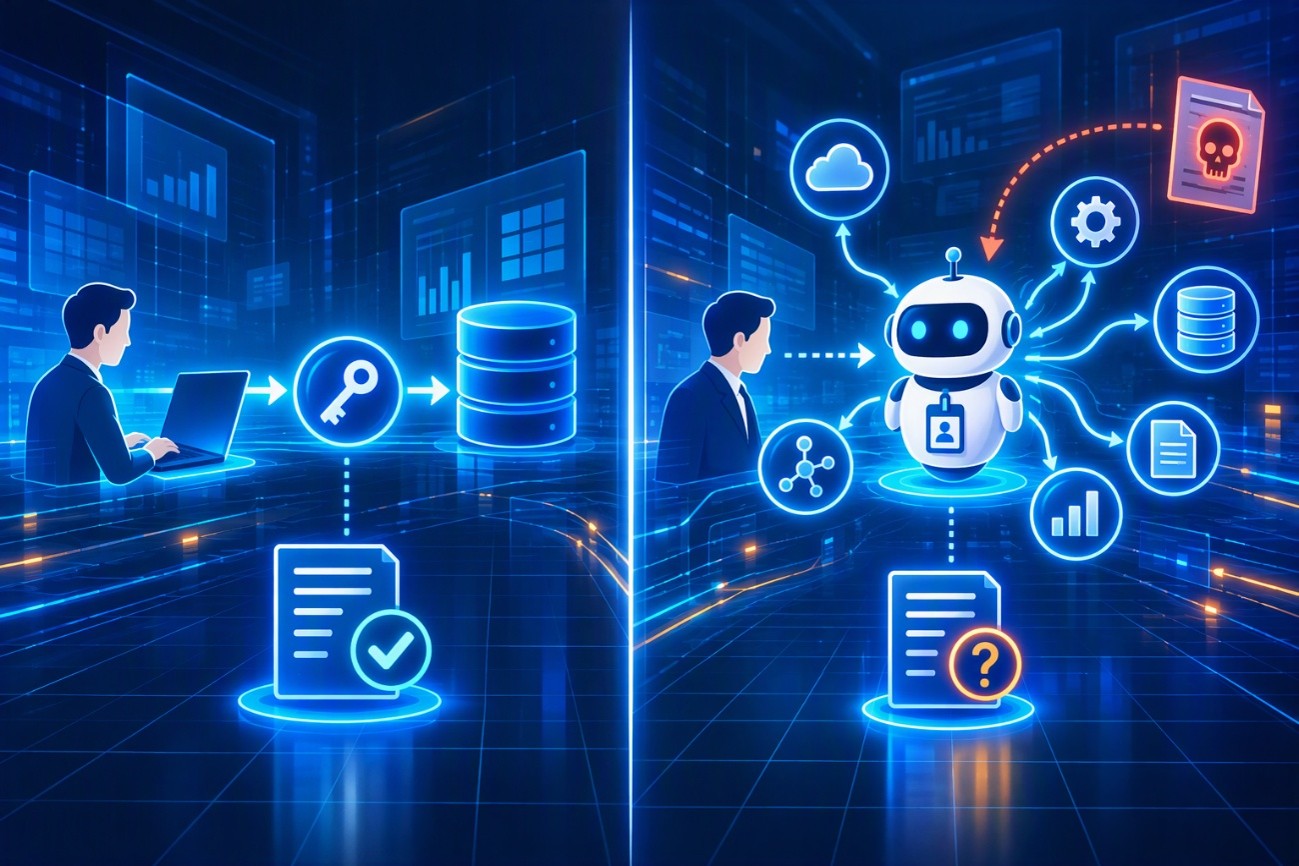
◆人のアクセスとエージェントのアクセスの違い
エージェントは作成者の権限をそのまま引き継いで動く
既定では、作成者の認証情報と権限のまま動作するエージェントも少なくありません。
エージェントは複数のツールを連鎖させながら、人よりも多くのクエリを24時間実行し続けます。ログに残るのが人のユーザー名だけでは、人の操作とエージェントの操作を区別できません。
外部からの指示でエージェントが操られるリスクがある
エージェントは読み込んだ文書やWebページの内容の影響を受けるため、そこに悪意ある指示が埋め込まれていると、本来の目的から外れた操作を実行するおそれがあります(プロンプトインジェクション)。OWASP(Open Worldwide Application Security Project)が2025年12月に公開した「OWASP Top 10 for Agentic Applications for 2026」でも、IDと権限の悪用が主要リスクの一つに挙げられています。
3.ガバナンスを支える3つの柱:識別・権限・監査
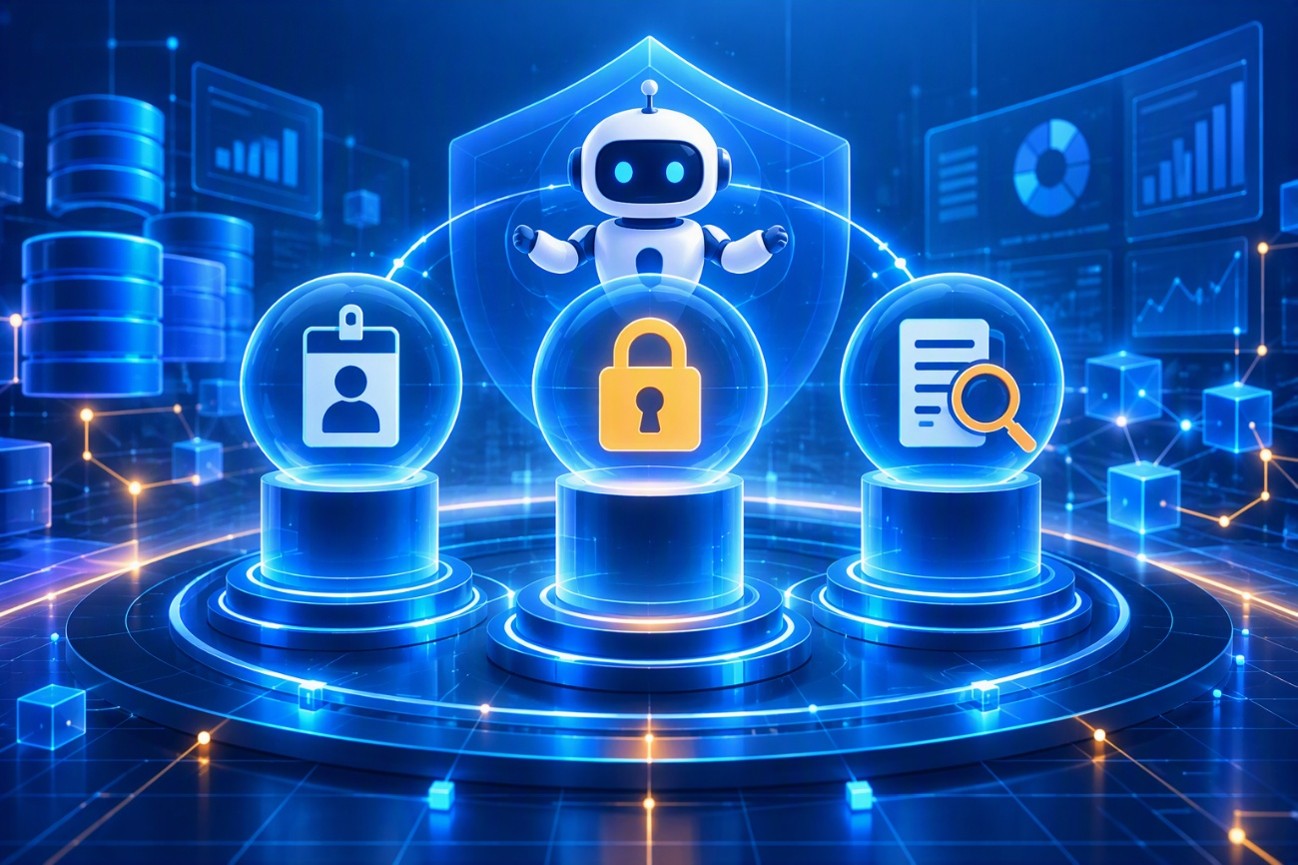
◆ガバナンスを支える3つの柱
識別(Identity):エージェントに固有のIDを与える
人のアカウントを使い回すのではなく、エージェント専用のID(非人間ID)を発行します。「どのエージェントが動いているか」を基盤側が認識できることが出発点です
権限(Authorization):タスクに必要な範囲へ絞る
最小権限の原則をエージェントにも適用します。考え方は「エージェントの権限=人の権限とエージェント用の制限範囲の重なり」です。エージェントが外部ツールへ接続する規格のMCP(Model Context Protocol)でも、認可を利用するHTTPベースの接続について、アクセストークンの利用対象を特定のMCPサーバーに限定し、別のサーバーでトークンが流用されるリスクを抑える仕組みが定められています。
監査(Audit):「人→エージェント→操作→データ」の因果関係を追う
ユーザーがどのエージェントを呼び出し、エージェントがどのクエリを実行し、どのデータにアクセスしたかを、単なる操作ログではなく一連の因果関係として監査証跡に記録します。
4.エージェントIDの2つの形:委任型と自律型
エージェントIDを設計するときは、エージェントが「誰の権限で動くか」で2つに分けて考えます。
項目
委任型(Delegated)
自律型(Autonomous)
動き方 ユーザーの代わりに、ユーザーのセッション内で動く
エージェント自身のIDと認可で動く
典型的な用途 対話型の分析エージェント、業務担当者のアシスタント
夜間に自動実行される監視・集計エージェント
IDの持ち方 ユーザー本人のIDのまま動き、セッションに「エージェント動作中」の目印(フラグ)を付けて人の直接操作と区別する
専用のユーザー(サービスID)を発行し、非対話型の認証を使う
監査で追うこと どのユーザーが、どのエージェントを使ったか
どのエージェントが、誰の承認のもとで動いているか
例えば担当者のAさんが分析エージェントに質問すると、クエリはAさんの権限で実行され、基盤側では「Aさんの代わりにエージェントが行った操作」として識別されます。
また、どちらの型でも、監査では次の3点を押さえます。
責任の所在:誰の指示・承認でエージェントが動いたか
操作の記録:どのデータにアクセスし、何を実行したか
振る舞いの妥当性:意図しない操作や不正な挙動がないか(普段と異なる大量のデータ取得、権限外へのアクセス試行など)
5.データ基盤側で実装するポイント(Snowflakeの例)
◆Snowflakeにおけるエージェントガバナンスの構成
Snowflake Cortex AgentsやSnowflake CoWorkなどSnowflake製のエージェントは、自動的に「エージェント動作中」のセッションとして扱われます。
自律型のエージェントには、専用のユーザータイプ「SERVICE_AGENT」(2026年7月に一般提供)を使います。
マスキングポリシーや行アクセスポリシーの条件に、エージェント動作中かを判定する「IS_AGENT_ACTIVATED」を組み込めます。
次の例では、エージェント経由のクエリではメールアドレスを常に伏せ字にし、人が直接参照する場合はANALYSTロールだけが元の値を確認できます。
■SQL
CREATE OR REPLACE MASKING POLICY email_mask_for_agent
AS (val STRING) RETURNS STRING ->
CASE
WHEN SYS_CONTEXT('SNOWFLAKE$CURRENT', 'IS_AGENT_ACTIVATED')::BOOLEAN = TRUE
THEN '********'
WHEN CURRENT_ROLE() IN ('ANALYST') THEN val
ELSE '********'
END;
ALTER TABLE customers MODIFY COLUMN email SET MASKING POLICY email_mask_for_agent;
さらに「Restricted Session Scope」(2026年9月に一般提供)を使うと、エージェントが動作している間だけ有効な権限の上限を設定できます。ユーザー権限との重なりだけが有効になり、新たな権限は付与されません。
例えば読み取り専用のスコープ「SNOWFLAKE$DATA_READ」をセッションポリシーに設定すれば、更新権限を持つユーザーでも、エージェント経由の操作は読み取りに限定されます。
▶【参考】Snowflake公式ドキュメント-
Restricted Session Scope for agents
クエリ履歴(QUERY_HISTORY)のagent_type列にはクエリを呼び出したエージェントの種別が、アクセス履歴(ACCESS_HISTORY)のagents_info列には関与したエージェントの一覧が記録され、因果関係をSQLで追跡できます。
AIクライアントやエージェントからモデルへのアクセスを一か所で統制する「Cortex AI Gateway」も2026年7月に発表されました(2026年10月時点ではパブリックプレビュー)。経路を一元化することで、次の利点があります。
●モデルの利用権限を一か所で付与・取り消しでき、無許可の利用を防ぎやすい
●リクエストごとのモデル、処理時間、トークン数などが記録され、AIがユーザーの代わりに何をしたかを確認できる
●利用料金をチームやユーザー単位で把握し、予算や利用上限を設定できる
最新の提供状況は公式ドキュメントをご確認ください。
▶【参考】Snowflake公式ドキュメント-
Cortex AI Gateway
6.導入時の注意点
専用の仕組みを一から作るのではなく、既存のRBACやポリシーにエージェントの観点を加えます。管理者ロールや共有ロールをそのまま渡さず、タスクごとに最小限のロールを定義します。
土台となるデータマネジメントが整っていなければ、エージェントの統制も機能しません。
作成者の異動や退職で「誰も管理していないエージェント」が残らないよう、エージェントにもオーナーを定め、ライフサイクルを管理します。
7.まとめ
AIエージェントのガバナンスとは、「誰の指示で、どのエージェントが、どのデータに、何をしたか」を把握し、統制できる状態にする取り組みです。
人向けの統制だけでは、権限の引き継ぎ、ログの判別、外部からの操作といった課題に対応しきれません。
SWTT 2026のデモや国内事例を通じて、ガバナンス設計をしっかり行えば、AIエージェントを本番ワークロードで利用できる段階に来ていると実感しました。
統制されたデータ基盤があってこそ、エージェントは安心して任せられる存在になります。
エージェントIDを中心とする識別・権限・監査は、どれか一つが欠けても成り立ちません。3つをそろえた土台の上で、一緒にAgentic Enterpriseの実践を進めていきませんか?
▼データマネジメントを詳しく知りたい方はこちらの記事もご覧ください。
関連記事
データマネジメントとは?基礎知識から実践・導入ステップまで徹底解説
▼Snowflake World Tour Tokyo 2026の参加レポートはこちらをご覧ください。
関連記事
~Agentic Enterpriseは日本で『実践』の段階へ~Snowflake World Tour Tokyo 2026 Keynote参加レポート
8.富士ソフトのデータ利活用支援について
富士ソフトでは、SIerとして培ってきた技術力と豊富な実績を基盤に、お客様の要件を起点としたデータ基盤全体の構成検討からご支援しています。
データ利活用する際、以下のお悩みを抱えていますでしょうか?
「データ基盤を新規で構築したい、または刷新したい」
「SQLが記述できない現場担当者でもデータを活用できる仕組みを構築したい」
「データ基盤のメタデータ設計についてサポートを受けたい」
富士ソフトでは、上記のお悩みを解決することが可能です。
データ分析・利活用ソリューションに関するお問い合わせ