Google Cloudデータベース"迷わない"選び方【前編】〜主要5製品を比較〜
Google Cloudのデータベースサービス、色々あってどれを使えば良いか分からなくなっていませんか?
はじめに
Google Cloud は用途に応じた複数のデータベースを提供しており、これは「選択肢の豊富さ=柔軟性の高さ」という大きな強みです。とはいえ、初めて触れる方にとっては、その選択肢の多さがそのまま悩みの種になってしまうのも事実です。
本記事は前編・後編の2部構成です。前編では、Google Cloudのデータベースの中から、用途の違いが分かりやすい代表的な5製品(Cloud SQL、AlloyDB for PostgreSQL、Spanner、Bigtable、Firestore)を取り上げ、違いと選び方を整理します。後編では、実際に手を動かしてアプリを作るハンズオンへとつなげます。まずは前編を読んで「どのDBを選べばよいか」の判断基準を掴みましょう。
ユースケース別・データベース選定フローチャート
大まかな判断軸は、「データモデル」と「アクセスパターン・スケール・可用性の要件」です。まずはシンプルな選定フローで方向性を掴みましょう。なお、AlloyDBのRead Poolは読み取り処理を水平に拡張する仕組みであり、Spannerのように書き込みを含めて自動的に水平分散する分散SQLとは性質が異なります。
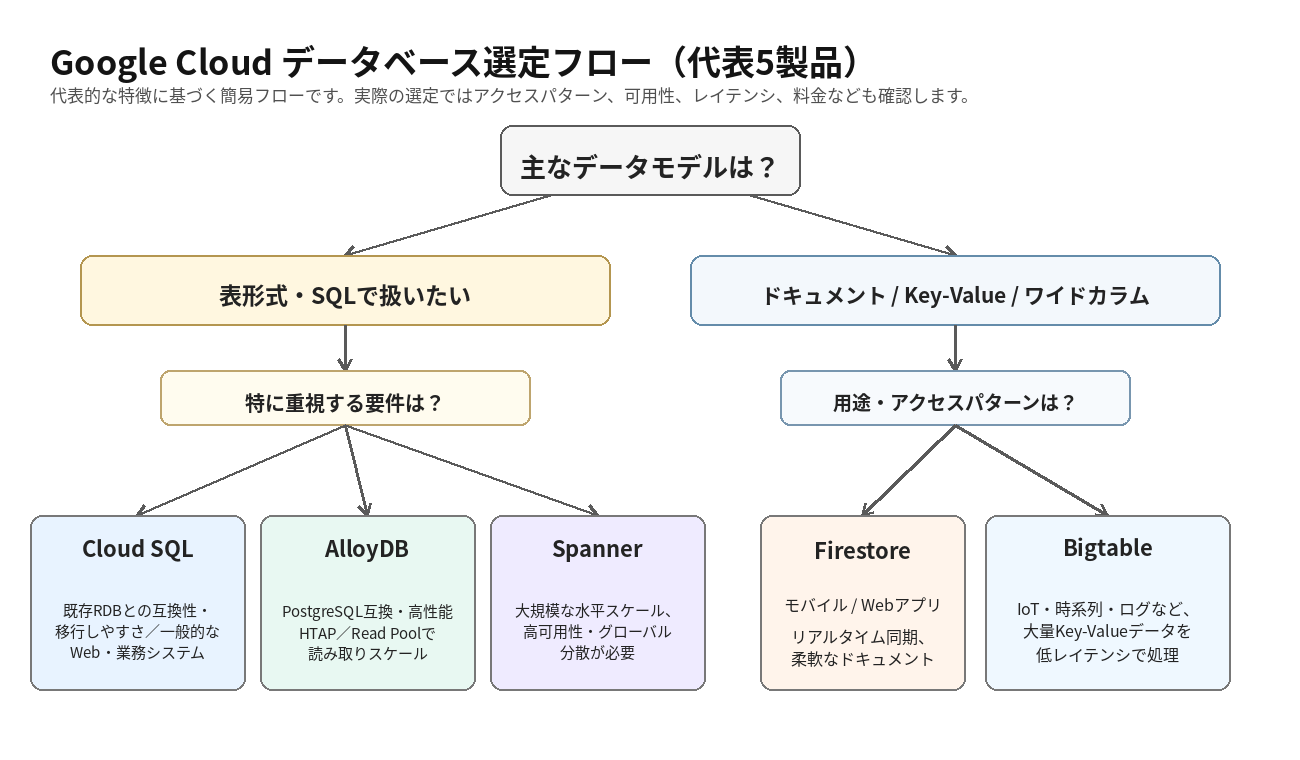
※ 本フローチャートは、各サービスの代表的な特徴に基づく簡易的な判断例です。実際の選定では、データ構造、アクセスパターン、整合性、可用性、レイテンシ、運用方法、リージョン構成、料金などを総合的に検討してください。
比較表
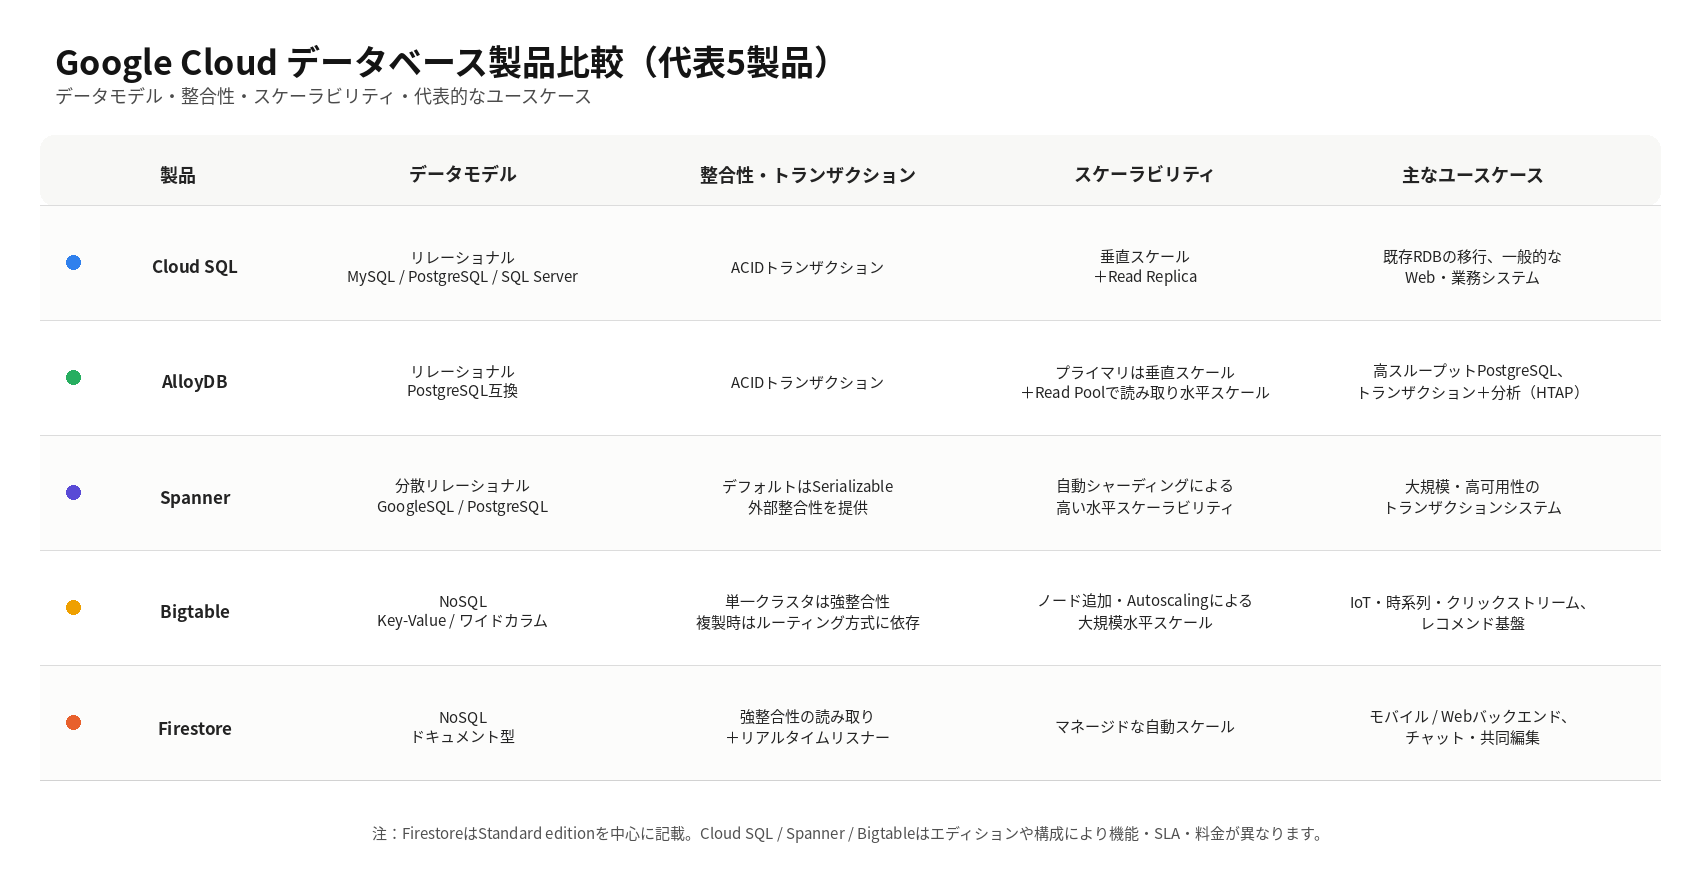
※画像をクリックすると拡大表示されます
※ FirestoreはStandard editionを中心に記載しています。Cloud SQL、Spanner、Bigtableはエディションや構成によって機能・SLA・料金が異なります。
※キャッシュ用途には Memorystore for Redis や Memorystore for Valkey、既存Oracleワークロードの移行には Oracle Database@Google Cloud も選択肢に入りますが、今回は上記5製品に絞って解説します。
各データベースの特徴と選定ポイント
1. Cloud SQL ― 既存RDBとの互換性・移行しやすさを重視するとき
強み:MySQL・PostgreSQL・SQL Serverに対応したフルマネージドのリレーショナルデータベースサービスで、バックアップ・高可用性(フェイルオーバー)・メンテナンスなどの運用機能が提供されます。
こんな時に使う:既存のMySQL・PostgreSQL・SQL Serverからの移行や、一般的なWebアプリ・業務システムなど、マネージドなリレーショナルデータベースを利用したい場合。
利用シーン例:ECサイトの注文管理、社内の勤怠・会員管理システム、既存RDBをクラウドへ移行するシステムなど。特に、既存アプリケーションとの互換性を維持しながら運用負荷を軽減したいケースに向いています。
料金の考え方:インスタンスのvCPU/メモリ、ストレージ、ネットワークなどが主な課金要素です。開発・検証環境では、使わないときにインスタンスを停止するとインスタンス料金を停止できますが、停止中もストレージやIPアドレスなどの料金は継続します。高可用性構成やRead Replicaを利用する場合は、その分のリソース料金も考慮します。
2. AlloyDB for PostgreSQL ― PostgreSQL互換で高性能・分析も両立したいとき
強み:PostgreSQL互換のフルマネージドデータベースです。必要に応じてColumnar Engineを有効化することで、スキャン・結合・集計などの分析クエリを高速化できます。また、Read Poolを利用して読み取り処理を水平に拡張できます。なお、PostgreSQLと高い互換性を持ちますが、利用する拡張機能などはAlloyDBのサポート状況を確認してください。
こんな時に使う:PostgreSQL互換性を保ちながら高いトランザクション性能や読み取り性能が必要なシステム、トランザクション処理と分析処理(HTAP)を同じデータベースで扱いたいエンタープライズシステム。
利用シーン例:会員数の多いSaaSプロダクトのマルチテナントDB、在庫や売上をリアルタイムに集計しながら同時にトランザクション処理も行いたい基幹システム。
料金の考え方:インスタンスのvCPU/メモリ・ストレージ・ネットワーク利用量などに応じた課金です。実際の費用は構成やワークロードによって異なります。
3. Spanner ― 規模も正確さも両方欲しいとき
強み:外部整合性(External Consistency)を提供しながら、高い水平スケーラビリティを備える分散リレーショナルデータベースです。StandardおよびEnterpriseエディションはリージョナル構成を中心に提供され、99.99%の可用性SLAです。Enterprise Plusではデュアルリージョン/マルチリージョン構成を利用でき、最大99.999%の可用性SLAが提供されます。
こんな時に使う:グローバル規模の金融システム、在庫・決済管理、大規模ゲームのユーザーデータ管理。
利用シーン例:複数リージョンでサービス展開する決済プラットフォーム、大量同時アクセスが発生するゲームのランキング・アイテム管理。
料金の考え方:選択するエディション、コンピューティング容量(ノードまたはProcessing Units)、データベースストレージ、バックアップ、ネットワーク利用量などに応じて料金が発生します。将来的なデータ量や処理量の増加が見込まれるシステムで、選択肢の一つとなります。
4. Cloud Bigtable ― とにかく量と速さが必要なとき
強み:Key-Value/ワイドカラム型のNoSQLデータベースで、数十億行規模まで水平にスケールできます。HBaseからの移行向けにHBase API 1.x/2.xと互換性のあるJavaクライアントも提供されていますが、HBaseとBigtableは完全に同一ではありません。単一クラスタでは強整合性で読み取れます。複数クラスタでレプリケーションする場合は基本的に結果整合性となり、同じクラスタへルーティングすることでread-your-writes整合性を確保できます。
こんな時に使う:IoTのセンサーデータ、広告のクリックログ、金融の時系列データ、レコメンドエンジンの基盤。
利用シーン例:工場設備から秒間数万件送られてくるセンサーログの蓄積、Webサービスの行動ログをリアルタイムでレコメンドに反映する基盤。
料金の考え方:主にノード数(またはオートスケーリングの設定)とストレージ量に応じた課金で、選択するエディション(Enterprise/Enterprise Plus)によっても料金が変わります。
5. Firestore ― リアルタイム性が欲しいアプリを作るとき
強み:ドキュメント指向でスキーマの柔軟性が高く、デフォルトで強整合性の読み取りを提供します。対応するクライアントSDKではリアルタイムリスナーを利用でき、Android・Apple・Webアプリではオフラインデータ操作にも対応しています。なお、Webではオフライン永続化はデフォルトで無効です。
こんな時に使う:モバイルアプリ・Webアプリのバックエンド、チャットや共同編集などリアルタイム性が求められるサービス。
利用シーン例:チャットアプリのメッセージ管理、複数人が同時編集するタスク管理アプリ、スタートアップのMVP開発でとにかく早くリリースしたいケース。
料金の考え方:本記事で主に想定するFirestore Standard editionでは、ドキュメントの読み取り・書き込み・削除などの操作量が課金の中心です。クエリによってはインデックスエントリの読み取りも課金対象になり、保存データ量やネットワーク利用量などにも料金が発生します。Enterprise editionは課金単位や一部機能が異なるため、利用するエディションの料金体系を確認してください。
まとめ&次回予告
前編では、Google Cloudの主要データベース5製品を「データモデル」「整合性・トランザクション」「スケーラビリティ」「ユースケース」という4つの軸で比較しました。
- 既存RDBとの互換性・移行しやすさを重視 → Cloud SQL
- PostgreSQL互換で高性能・HTAP・読み取りスケール → AlloyDB
- 大規模な水平スケールと高い整合性・可用性 → Spanner
- 大量のKey-Value/時系列データを低レイテンシで → Bigtable
- モバイル/Webバックエンドでリアルタイム同期 → Firestore
データベース選定の判断基準は掴めたと思いますが、実際に触ってみないと使い勝手はわかりません。次回の後編ではFirestore Standard editionを使ってシンプルなアプリを実際に構築するハンズオンをお届けします。「リアルタイム同期ってどれくらい簡単に実装できるの?」を、コードとともに体感していただきますので、ぜひお楽しみに!